Анализ лог-файлов: руководство по SEO-оптимизации сигналов от ИИ-ботов
Журналы сервера - единственный источник данных, который регистрирует каждое посещение вашего сайта ИИ-ботом в режиме реального времени: без выборки, без выводов, без задержек.
10 октября 2026 г.
В данном руководстве объясняется, как извлекать журналы ИИ-ботов с помощью шести основных платформ серверной аналитики, какие поля отслеживать на каждой платформе и как использовать рабочий процесс SIGNAL для преобразования необработанных данных журналов в очередь приоритетных географических правок.
Анализ логов сервера уже много лет является неотъемлемой частью технической SEO-оптимизации. Когда вы извлечете необработанные журналы доступа (access.log и ему подобные) с вашего сервера и отфильтруете их по поисковым роботам, то вы получите достоверную информацию о том, что произошло на вашем сайте на самом деле: какие страницы проиндексировал Яндексбот, какие пропустил, какие коды состояния получил и как изменилась частота индексации после изменения сайта. Никакой выборки, никаких выводов, никаких панелей мониторинга, интерпретирующих поведение от вашего имени.
Принцип работы остался прежним. Изменилось лишь то, кто еще фигурирует в журналах.
Проще говоря: аналитика вашего сайта показывает, кто выбрал именно вас. Журналы сервера показывают, кто решает, рекомендовать ли вас другим. Но это не одна и та же аудитория, и разрыв между ними увеличивается с ежемесячно.
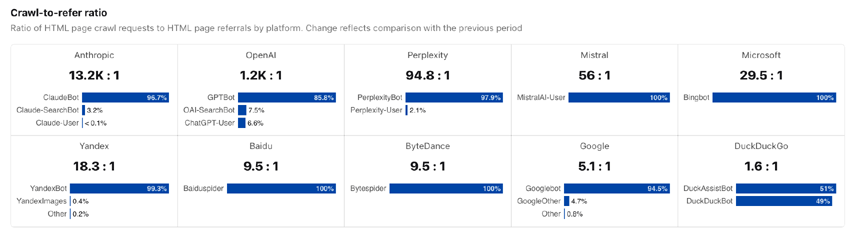
Согласно данным Cloudflare Radar о соотношении запросов на сканирование и переходов по ссылкам, которые возвращаются на сайты издателей, ClaudeBot сканирует 13 528 страниц на каждый переход по ссылке, который он отправляет обратно в интернет (неделя с 13 по 20 апреля 2026 года). Соотношение для краулеров OpenAI составляет 1252 к 1. Googlebot работает с соотношением 5:1 – пять просканированных страниц, пять вернувшихся посетителей. Соотношение меняется каждую неделю, но структурный дисбаланс остается неизменным с тех пор, как Cloudflare начала его отслеживать.
Ни одно из этих событий сканирования не отображается в Яндекс Вебмастере, Google Search Console или на каких-либо стандартных панелях отчетности. Они существуют только в одном месте: в журналах вашего сервера.
Масштабы платформ, запускающих деятельность по сбору веб-контента, весьма значительны. Согласно отчету Similarweb «Ландшафт генеративного ИИ 2025», за год до сентября 2025 года платформы генеративного ИИ в среднем ежемесячно обрабатывали 7 миллиардов посещений по всему миру, что на 76% больше, чем годом ранее.
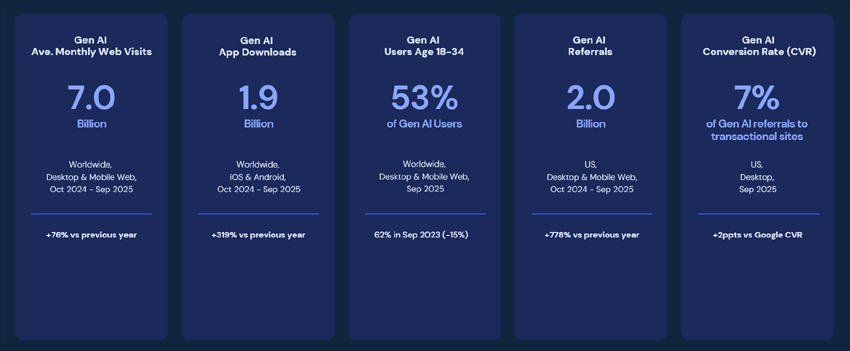
Этот рост приводит к соответствующему всплеску активности поисковых роботов: чем больше пользователей задают больше вопросов, тем больше запросов на получение данных в режиме реального времени поступает на большее количество сайтов, и чаще.
Тот же метод, который SEO-специалисты использовали для понимания поведения Googlebot при сканировании, теперь позволяет отслеживать поведение агентов искусственного интеллекта: какие боты доходят до вашего сайта, какие страницы они посещают и в каком порядке, какие технические проблемы блокируют их в процессе сканирования и является ли полученный ими контент той версией, которую вы действительно хотите видеть на сайте.
Вопросы те же. Однако, ставки уже другие.
Анализ 24,5 миллионов прокси-запросов на 69 сайтах клиентов, проведенный компанией Alli AI с января по март 2026 года и опубликованный в Search Engine Journal, показал, что связанные с ИИ поисковые роботы в совокупности выполнили в 3,6 раза больше запросов, чем традиционные поисковые роботы вместе взятые. В том же наборе данных ChatGPT-User превзошел Googlebot, Amazonbot и Bingbot вместе взятые. Этот вывод отличается от совокупного соотношения: он относится только к поисковому роботу OpenAI, выполняющему поиск в реальном времени.
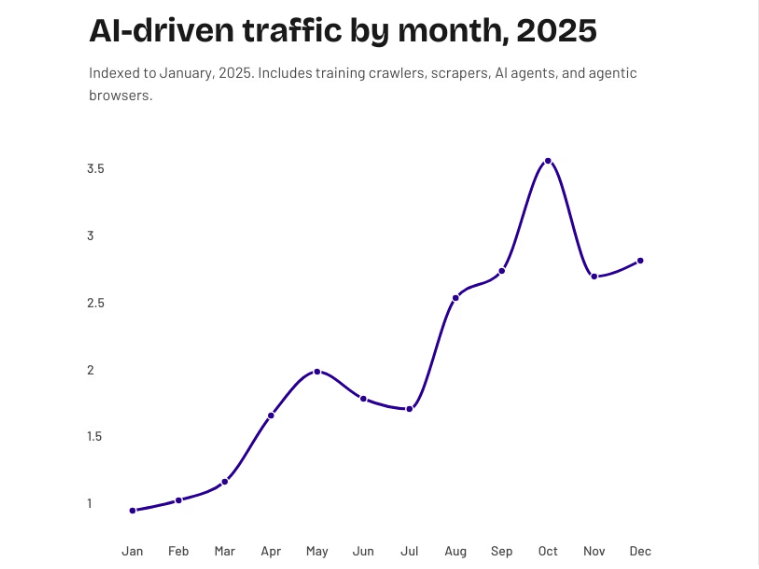
Между тем, автоматизированный трафик растет в восемь раз быстрее, чем трафик, управляемый людьми: согласно отчету HUMAN Security «Состояние трафика ИИ и киберугроз в 2026 году», объем трафика, управляемого ИИ, увеличился на 187% с января по декабрь 2025 года.
Анализ лог-файлов всегда был самым честным методом диагностики для технической SEO-оптимизации. В 2026 году это также самый важный доступный метод технической географической диагностики.
В данном руководстве рассматривается содержимое серверных журналов, способы их извлечения из шести основных платформ WAF (Web Application Firewall), CDN и управления журналами, а также то, как замкнуть цикл анализа сайта с помощью сервиса ЛогАналайзер и как преобразовать полученные данные в приоритетную очередь исправлений.
Преимущества анализа лог-файлов для поиска в геопространстве и с использованием искусственного интеллекта
Большинство геолокационных тактик основаны на предположениях. Вы предполагаете, что боты с искусственным интеллектом достигают ваших самых важных страниц. Вы предполагаете, что контент, который они загружают, является неизменным, а не пустым из-за рендеринга JavaScript. Вы предполагаете, что ваш WAF (Web Application Firewall) не блокирует незаметно те страницы, которые вам больше всего нужны.
Анализ лог-файлов заменяет эти предположения фактами.
Вот что именно он вам дает.
Преимущество 1: Единственный объективный показатель видимости ИИ в поисковой выдаче
Каждый инструмент измерения на уровне платформы имеет предвзятость в отношении того, что эта платформа хочет вам сообщить. Google Search Console показывает данные Googlebot, которые Google обработал и решил отобразить. GA4 фильтрует ботов по своей сути. Ни один из подобных инструментов аналитики не показывает, что делают ChatGPT, Perplexity или Claude на вашем сайте.
В лог-файлах такой предвзятости нет. Они записывают каждый HTTP-запрос, отправленный на ваш сервер, независимо от его источника: веб-краулеры, индексаторы поиска, пользовательские запросы и посетители (реальные люди) – все они отображаются в одном неотфильтрованном потоке. В частности, для поиска с использованием ИИ это означает, что вы можете измерять фактическую активность ботов, а не выводить ее из косвенных сигналов, таких как реферальный трафик или упоминания брендов в ответах ИИ.
В этом и заключается главное преимущество анализа лог-файлов для поиска с использованием ИИ: это единственный источник измерений, который не требует от платформ ИИ обмена данными с вами.
Преимущество 2: Диагностика различий между проблемой доступа и проблемой цитирования
Наиболее распространенная ошибка в диагностике GEO – это рассмотрение каждого пробела в цитировании как проблемы качества контента. Анализ лог-файлов позволяет различить два реально существующих режима сбоев.
- Страница, которая регулярно получает запросы от пользователей ChatGPT, но никогда не генерирует цитаты, имеет проблему со структурой контента. Бот обращается к странице, но не извлекает ничего, что можно было бы процитировать. Необходимо исправить контент.
- Страница, на которую не поступает ни одного запроса от ChatGPT-User, имеет проблему с доступом. Бот вообще не может к ней получить доступ, независимо от качества контента. Необходимо исправить проблему с доступом к странице.
Со стороны эти две ситуации выглядят идентично. Но в логах они совершенно разные. Любая тактика географической оптимизации, применяемая к странице с проблемой доступа, – это пустая трата времени, пока проблема доступа не будет решена. Анализ логов позволяет определить проблему до того, как вы потратите время на ее решение.
Преимущество 3: Измерение взаимодействия ChatGPT с вашим сайтом с помощью всех трех его ботов
Анализ лог-файлов для оценки видимости ChatGPT отличается от измерения показателей любой другой платформы искусственного интеллекта, поскольку ChatGPT работает через трех ботов, каждый из которых представляет собой отдельный этап взаимодействия с вашим контентом.
- GPTBot показывает, что OpenAI изучает о вашем сайте с течением времени. Регулярное сканирование GPTBot означает, что ваш контент попадает в обучающие данные OpenAI. Пробелы в охвате GPTBot означают, что эти страницы отсутствуют в знаниях модели OpenAI.
- OAI-SearchBot предоставляет информацию о покрытии вашего индекса в поиске ChatGPT. Частота сканирования страницы коррелирует с тем, насколько эта страница доступна, когда пользователь задает ChatGPT вопрос, на который будет получен результат поиска.
- ChatGPT-User показывает активность цитирования в реальном времени. Он срабатывает, когда запрос активного пользователя заставляет ChatGPT загрузить вашу страницу по требованию. Это наиболее прямое доказательство того, что ваш контент используется в активном диалоге с использованием искусственного интеллекта.
Отслеживание всех трех уровней по отдельности в ваших журналах дает вам поэтапное представление о видимости вашей активности в ChatGPT: что знает OpenAI, что может получить ChatGPT Search и что фактически цитируется в реальных разговорах. Ни один другой источник данных не предоставляет все три уровня.
Преимущество 4: Геообратная связь, не зависящая от сотрудничества с платформой искусственного интеллекта
В традиционном SEO используется Яндекс Вебмастер и Google Search Console. В платной поисковой рекламе есть панели мониторинга конверсий. В GEO в настоящее время нет ни того, ни другого. ChatGPT, Perplexity и Claude не публикуют данные о том, как часто они цитируют тот или иной сайт, какие страницы считают наиболее полезными или почему перестают цитировать страницу после изменений на сайте.
Анализ серверных лог-файлов – это практичная альтернатива. Он не предоставляет данные о количестве цитирований, но дает исходные данные, на основе которых принимаются решения о цитировании: какие страницы посещают боты, как часто, что они получают и где сталкиваются с ошибками. Постоянное отслеживание этих данных во времени позволяет сопоставлять изменения на вашем сайте с изменениями в поведении ИИ-ботов и создавать обратную связь, которой GEO иначе не обладает.
Что содержат файлы журналов (и почему боты и агенты с искусственным интеллектом делают их более интересными)?
Анализ лог-файлов – это практика изучения журналов доступа к серверу, представляющих собой необработанные записи с временными метками каждого HTTP-запроса к вашему сайту, чтобы понять, как боты и пользователи фактически взаимодействуют с вашим контентом. Каждый запрос генерирует одну строку: IP-адрес, временная метка, HTTP-метод, URL, код состояния, количество переданных байтов и строка User-agent. Никакой выборки. Никаких выводов. Никаких задержек.
В отличие от других источников данных:
| Что измеряем | Файлы журналов сервера | Google Search Console | GA4 |
|---|---|---|---|
| Тип данных | Необработанные HTTP-запросы | Сводная статистика сканирования | Пользовательские сессии |
| Объем | Все боты и пользователи | Googlebot только | Поток пользователей (боты отфильтрованы) |
| Задержка | В реальном времени | Задержка на 2-3 дня | Задержка примерно на 24 часа |
| Видимость ИИ-ботов | Полный | Никто | Никто |
| Отбор проб | Никто | Образцы | Образцы |
| Расходы | Бесплатно | Бесплатно | Бесплатно |
Google Search Console показывает лишь то, что Google решил вам сообщить о Googlebot.
При этом, ваши журналы показывают все остальное.
Какие боты заходят на ваш сайт и когда?
Журналы событий подтверждают, какие страницы посещали краулеры с искусственным интеллектом, объем запросов, частоту сканирования по разделам сайта и закономерности во времени. Высокая частота сканирования определенной страницы краулерами с искусственным интеллектом является разумным показателем воспринимаемого авторитета, основанным на наблюдаемых закономерностях частоты сканирования.
Низкая частота показа вашего лучшего контента – это пробел, который следует диагностировать, а не мириться с ним.
Какие ответы дал им ваш сервер?
Каждый код состояния – это сигнал, имеющий прямое конкретное значение. Код 200 означает успешное получение данных. Код 404 сообщает боту, что контент по этому URL-адресу отсутствует: он возвращает пустые данные. Код 304 (Not Modified) указывает боту использовать кэшированную копию, которая может быть устаревшей, если вы опубликовали обновление несколько недель назад. Код 429 (Too Many Requests) сообщает боту, который активно пытался получить контент, что вы ему отказали. 100 самых распространенных ошибок в SEO.
Каждый ответ от поискового бота, отличный от 200, может привести к пропуску важной ссылки.
Как объем работы ИИ-ботов влияет на ваш бюджет сканирования Googlebot
«Бюджет сканирования» – это понятие, определенное Google: количество URL-адресов, которые Googlebot может и хочет просканировать на сайте в течение определенного периода времени, как это определено в документации Google Search Central.
У ботов с искусственным интеллектом нет собственного бюджета на обход системы. Зато у них есть огромный аппетит.
Согласно анализу аудитов корпоративных сайтов, проведенному специалистами-практиками, было замечено, что ИИ-краулеры потребляют до 40% всей активности сканирования на сайтах с высокой посещаемостью (SEOmator, март 2026 г.). Когда ИИ-боты конкурируют с Googlebot за одинаковую серверную мощность и пропускную способность, Googlebot получает меньше. Анализ логов – единственный инструмент, позволяющий увидеть эту конкуренцию.
Есть и вторая причина, по которой анализ логов сейчас важнее отслеживания переходов: переходы через ИИ достигли своего предела. Согласно отчету Similarweb «AI Brand Visibility Report 2026», количество посещений платформ ИИ продолжает расти, в то время как исходящие переходы перестали расти, поскольку чат-боты превращаются в комплексные решения, удерживающие пользователей на платформе.
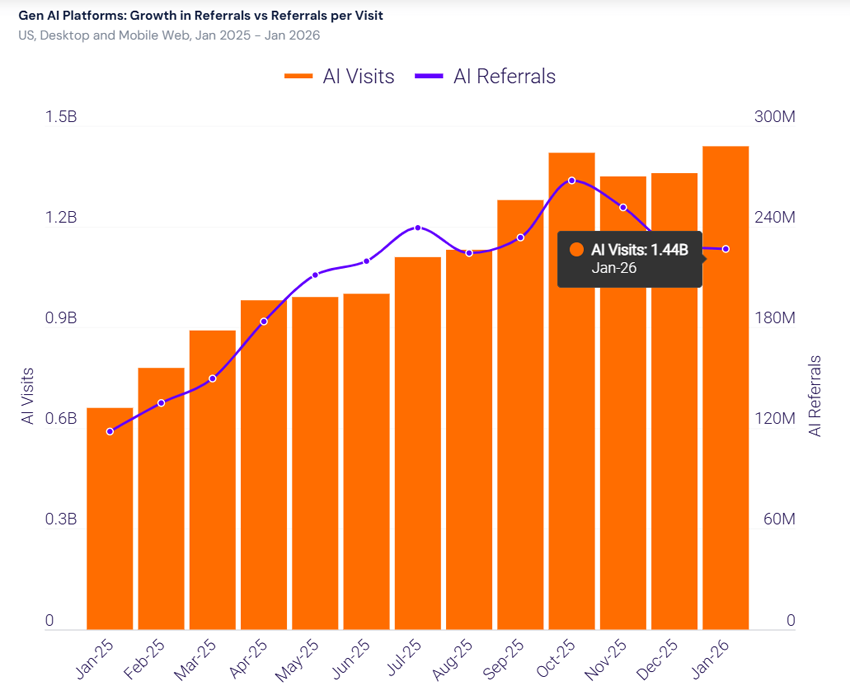
Стандартные методы анализа реферальных ссылок будут все чаще недооценивать влияние ИИ. Журналы событий – единственный канал, где сохраняется полная картина.
Необходимая классификация ИИ-ботов перед открытием хотя бы одного лог-файла
Боты с искусственным интеллектом в логах вашего сервера делятся на три категории с различными географическими особенностями. То, к какой категории относится бот, определяет ваши действия при его обнаружении. Неправильная классификация приведет к неправильной стратегии контроля доступа.
Тренировочные краулеры
Обучающие веб-краулеры собирают контент для создания или доработки больших языковых моделей. Они определяют, что системы искусственного интеллекта знают о вашем бренде и контенте в долгосрочной перспективе.
Основные обучающие веб-программы:
- GPTBot (OpenAI)
- ClaudeBot (Anthropic)
- meta-externalagent (Мета)
- Программа Google Extended (отказ от участия в программе обучения Google Gemini)
- CCBot (Common Crawl)
- Bytespider (ByteDance)
Данные о соотношении количества посещений к количеству переходов позволяют лучше понять стратегическую картину. Соотношение 13528:1 у ClaudeBot означает, что Anthropic получает гораздо больше, чем возвращает. Если вы хотите отказаться от предоставления контента для обучения модели, сохраняя при этом присутствие ИИ в поисковой выдаче, заблокируйте GPTBot и Google-Extended в Robots.txt, разрешив при этом OAI-SearchBot и Claude-SearchBot.
Обучающие веб-краулеры учитывают файл Robots.txt. Однако поисковые боты, описанные ниже, все чаще этого не делают.
Согласно отчету Fastly об угрозах за второй квартал 2025 года, на поисковые роботы с искусственным интеллектом приходилось приблизительно 80% всего трафика от ботов с ИИ, наблюдаемого в их сети, при этом meta-externalagent генерировал более половины общего объема трафика от таких роботов, превзойдя по этому показателю Google и OpenAI вместе взятые.
Поисковые индексаторы
Индексаторы поиска заполняют базы данных, к которым обращаются поисковые системы с использованием искусственного интеллекта при ответе на вопросы пользователей в режиме реального времени.
Ключевые поисковые индексаторы:
- Yandexbot
- Googlebot (который также предоставляет данные для обзоров ИИ)
- OAI-SearchBot (поисковый робот OpenAI, отличающийся от GPTBot)
- PerplexityBot
Стандартная схема контроля доступа для операторов, желающих использовать поиск с помощью ИИ без участия в обучении модели: разрешить OAI-SearchBot, запретить GPTBot. Эти параметры контролируются независимо друг от друга.
Запросы, запускаемые пользователем
Боты, запускаемые пользователем, активируются, когда реальный пользователь задает ИИ вопрос, требующий актуальной информации. Они загружают страницы в режиме реального времени в момент запроса. Это категория с наивысшим приоритетом для показателей цитирования в геолокации. Эти боты определяют, появится ли ваш контент в конкретном ответе конкретному человеку прямо сейчас.
Ключевые средства получения данных:
- ChatGPT-User (OpenAI)
- Пользователь Perplexity (Perplexity)
Начиная с обновления документации по веб-краулеру от OpenAI от 9 декабря 2025 года, ChatGPT-User больше не соответствует требованиям Robots.txt. OpenAI удалила формулировку о соответствии Robots.txt, которая ранее применялась ко всем трем пользовательским агентам, оставив ее только для GPTBot и OAI-SearchBot.
Обоснование OpenAI: ChatGPT-User функционирует как расширение запроса от реального пользователя, а не как автономный веб-сканер.
GPTBot и OAI-SearchBot по-прежнему учитывают robots.txt. ChatGPT-User этого не делает. Если вы видите трафик от ChatGPT-User в своих логах, он поступает независимо от конфигурации Robots.txt.
В этой категории также рассматривается начало уровня агентного поиска. По мере того, как системы ИИ развиваются от ответов на отдельные вопросы к выполнению многоэтапных задач от имени пользователя, в журналах отображаются запросы, инициируемые пользователем, когда агент активно работает.
Запрос от бота ChatGPT-User – это не просто сигнал о цитировании, а доказательство того, что агент посчитал вашу страницу достойной загрузки для выполнения задачи. Таким образом, данные журнала представляют собой верхнюю ступень трехэтапной воронки:
- Доступ – получил ли агент доступ к вашему контенту?
- Ссылка – была ли в ответе ссылка на вашу страницу?
- Действия агента – что он или пользователь сделали после прибытия?
Анализ логов охватывает первый этап, анализ цитирований с помощью ИИ – второй, а оптимизация поиска с помощью агентных методов – третий.
Полная справочная таблица по ИИ-ботам
| Бот | Владелец | Категория | Строка User-Agent | Соответствует ли Robots.txt требованиям? |
|---|---|---|---|---|
| GPTBot | OpenAI | Обучение | GPTBot/1.3 | Да |
| OAI-SearchBot | OpenAI | Поисковый индекс | OAI-SearchBot/1.3 | Да |
| ChatGPT-User | OpenAI | Получение данных в реальном времени | ChatGPT-User/1.0 | Нет |
| ClaudeBot | Anthropic | Обучение | ClaudeBot | Да |
| Claude-SearchBot | Anthropic | Поисковый индекс | Claude-SearchBot | Да |
| PerplexityBot | Perplexity | Поисковый индекс | PerplexityBot/1.0 | Спорный* |
| Perplexity-User | Perplexity | Получение данных в реальном времени | Perplexity-User/1.0 | Спорный* |
| Google-Extended | Отказ от обучения | Google-Extended | Да | |
| meta-externalagent | Meta | Обучение | meta-externalagent | Да |
| Bytespider | ByteDance | Обучение | Bytespider | Непоследовательный |
| Amazonbot | Amazon | ИИ/Алекса | Amazonbot | Да |
| CCBot | Common Crawl | Обучение | CCBot | Да |
Один из важных шагов проверки, который стоит включить в ваш процесс: не каждый запрос, выдающий себя за GPTBot, на самом деле им является. Обратная DNS-проверка проверяет выборку IP-адресов ботов. IP-адрес должен разрешаться в домен, соответствующий заявленной инфраструктуре оператора (например, *.openai.com для GPTBot).
ЛогАналайзер делает это автоматически.
Какие поля из файлов журналов вашего сервера следует извлечь?
Не все поля логов одинаково полезны. Логи WAF и CDN могут содержать десятки полей на один запрос, и их анализ излишний и медленный. Извлечение всех необработанных данных также может привести к дополнительным затратам и огромному размеру файлов. По этим причинам мы считаем, что лучше всего извлекать только те поля, которые полезны для SEO и поисковой оптимизации с использованием ИИ.
Основные поля access.log для анализа
`timestamp`
Дата и время каждого запроса. Используйте это для отслеживания частоты сканирования с течением времени и выявления всплесков активности ИИ-ботов после публикации контента или изменения сайта. Сортировка по временной метке также позволяет определить, сканирует ли ваш сайт конкретный бот по расписанию или реагирует на внешние триггеры.
Вместе с client_ip и user_agent, timestamp является одним из трех полей, используемых для восстановления агентских сессий: группировка запросов с одного и того же IP-адреса и user-agent в пределах определенного временного окна позволяет увидеть полный путь, пройденный агентом ИИ по страницам вашего сайта.
`client_ip`
IP-адрес отправителя запроса. Поле, используемое для обратной проверки DNS: IP-адрес должен соответствовать инфраструктуре, принадлежащей заявленному оператору бота. IP-адреса GPTBot соответствуют Microsoft Azure, ClaudeBot – AWS, а PerplexityBot – Google Cloud. Несоответствия указывают на поддельные строки User-agent.
Для восстановления агентской сессии client_ip является основным ключом группировки: запросы, использующие один и тот же IP-адрес, user-agent и имеющие узкий временной интервал, почти наверняка относятся к одному и тому же агенту, выполняющему задачу.
Один IP-адрес, последовательно обращающийся к /pricing/, /features/ и /case-studies/ в течение трех минут, – это не обучающий веб-краулер: это агент, сравнивающий варианты от имени пользователя.
`user_agent`
Основное поле для определения того, какой ИИ-бот отправил запрос. Поле `user_agent` содержит имя бота, версию и URL-адрес оператора в одной строке, например, Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; GPTBot/1.4; +https://openai.com/gptbot). При любом анализе сначала следует использовать фильтр по этому полю.
`uri`
Точный URL-адрес, запрошенный ботом. Это показывает, к каким страницам обращаются боты с искусственным интеллектом и насколько глубоко они сканируют ваш сайт. Отсортируйте по частоте URI, чтобы определить наиболее часто сканируемые страницы, и сравните этот список с целевыми географическими зонами.
`http_method`
Используемые HTTP-методы: GET, POST, HEAD и т. д. Искусственные интеллекты-краулеры используют GET почти исключительно. Любые другие запросы от ботов, выдающих себя за GPTBot или ClaudeBot, заслуживают внимания.
`response_code_sent`
Код состояния HTTP, возвращенный вашим сервером. Наиболее полезное поле для географического анализа: 200 означает, что бот получил ваш контент, 404 – что он вернул ничего, 429 – что вы ограничили количество запросов, 5xx – что-то сломалось на стороне сервера.
Каждый код, отличный от 200, полученный от поискового бота, является потенциальной причиной пропуска ссылки.
`action`
Решение WAF: ALLOW (разрешить), BLOCK (заблокировать), COUNT (подсчитать) или CAPTCHA (капча). Блокировка означает, что бот так и не достиг вашего источника и не будет отображаться в каких-либо логах на стороне сервера. Это отображается только в логах WAF. Если вы хотите понять, почему бот был заблокирован, добавьте поле bot_control_rules в свой экспорт: оно содержит конкретное правило, которое сработало, например, CategoryAI или SignalNonBrowserUserAgent.
`referer`
URL-адрес, который отправил бота на вашу страницу. Пустое поле для самообучающихся веб-краулеров. Заполняется для веб-краулеров, запускаемых пользователем, таких как ChatGPT-User, когда реальный пользователь или ИИ-агент переходит по ссылке из диалога ChatGPT. Непустой реферер от ИИ-бота является прямым сигналом активного взаимодействия: кто-то или что-то выполняло задачу, которая привела на вашу страницу.
В контексте агентного поиска последовательность запросов ChatGPT-User на нескольких страницах вашего сайта в течение короткого промежутка времени является еще более сильным сигналом: агент перемещается по вашему контенту, а не просто получает один ответ.
`country`
Географическое происхождение запроса определяется на основе геолокации IP-адреса. Это полезно для выявления поддельного бот-трафика. GPTBot, как правило, исходит из инфраструктуры Azure, расположенной в США. Запросы, выдающие себя за GPTBot, но поступающие из неожиданных географических регионов, требуют проверки.
Дополнительные поля (если они доступны)
`labels`
Самое информативное поле в журнале AWS WAF. Строка, разделенная символом вертикальной черты, содержащая все метки, которые AWS Bot Control применил к запросу, включая awswaf:managed:aws:bot-control:bot:name:gptbot, bot:category:ai, bot:verified или bot:unverified, а также коды регионов.
Таким образом AWS WAF передает всю известную ему информацию о запросе в одном месте. Для целей SEO различие между bot:verified и bot:unverified особенно полезно: IP-адрес проверенных ботов подтвержден по опубликованным диапазонам IP-адресов оператора; IP-адрес непроверенных ботов – нет.
`terminating_rule_id`
Идентификатор правила WAF, принявшего окончательное решение о разрешении или блокировке запроса. Полезно для диагностики того, правильно ли ваш WAF обрабатывает известные боты с искусственным интеллектом. Если пользовательское правило разрешения, например ALLOW-VERIFIED-BOTS, завершается для GPTBot, значит, ваш список разрешенных ботов работает.
Если вместо этого завершается действие общего правила блокировки, значит, бот останавливается до того, как достигнет вашего контента.
`args`
Параметры строки запроса добавляются к запрашиваемому URL-адресу. Обычно они пустые для обхода веб-страниц ботами с искусственным интеллектом. Заполненные параметры строки запроса в запросах ботов могут указывать на параметризованное поведение сбора данных, а не на стандартный обход страниц.
`http_source_id`
Идентификатор дистрибутива CloudFront. Полезен, когда вы используете несколько дистрибутивов на разных серверах и вам необходимо привязать записи журналов к конкретному сайту.
`request_id`
Уникальный идентификатор, присваиваемый каждому отдельному запросу WAF. Присутствует в экспорте журналов AWS WAF как request_id. Его основное значение – межпотоковая корреляция: при объединении журналов WAF с журналами доступа CloudFront для получения как решений по безопасности, так и метрик ответа (отправлено байтов, TTFB, состояние кэша) для одного и того же запроса, request_id является ключом объединения.
На уровне агентской сессии последовательность значений request_id, отсортированных по временной метке, для одного и того же client_ip и user_agent дает точную, упорядоченную запись каждой страницы, посещенной агентом, в том порядке, в котором он их посещал.
Как восстановить сессии агентов из необработанных полей логов
В логах WAF и CDN отсутствует собственный идентификатор сессии для ботов с искусственным интеллектом, но вы можете восстановить сессии, сгруппировав их по трем полям: client_ip + user_agent + временной интервал (30 минут – стандартный интервал для сессий с участием людей, а 5 минут – более подходящий для агентов с искусственным интеллектом, которые работают быстрее). Любая группа запросов, соответствующих всем трем критериям в последовательности, является сессией.
Отсортируйте данные по временной метке внутри каждого кластера, и вы получите полный упорядоченный маршрут: какие страницы посетил агент, в каком порядке, какие коды состояния он получил на каждом шаге и где завершилась сессия.
Сессия, которая проходит страницу с ценами, страницу сравнения и страницу контактов, прежде чем остановиться, – это визит с высокой степенью заинтересованности и активностью. Сессия, которая проходит только одну страницу и возвращает ошибку 404, – это упущенная конверсия на уровне доступа. В агрегированных данных о трафике эти два явления выглядят одинаково. В логах же это совершенно разные сигналы.
Именование полей на разных платформах
Названия полей различаются в зависимости от платформы. В AWS журналы WAF и журналы доступа CloudFront представляют собой отдельные потоки с разными названиями полей. Оба типа потоков описаны ниже:
| Источник данных | AWS WAF (CloudWatch) | AWS CloudFront (журнал доступа) | Cloudflare (Logpush) | Быстро (VCL) | Akamai DataStream 2 |
|---|---|---|---|---|---|
| User-agent | user_agent | cs(User-Agent) | ClientRequestUserAgent | req.http.User-Agent | UA |
| URL-путь | uri | cs-uri-stem | ClientRequestURI | req.url | reqPath |
| Код состояния | response_code_sent | sc-status | EdgeResponseStatus | resp.status | statusCode |
| IP-адрес клиента | client_ip | c-ip | ClientIP | client.ip | cliIP |
| Отметка времени | timestamp | date + time | EdgeStartTimestamp | time.start.msec | reqTimeSec |
| Действия WAF | action | N/A | FirewallMatchesActions | N/A (VCL custom) | securityRules |
| Реферер | referer | cs(Referer) | ClientRequestReferer | req.http.referer | referer |
| Страна | country | N/A | ClientCountry | client.geo.country_code | country |
| Отправлено байтов | N/A | sc-bytes | EdgeResponseBytes | resp.body_bytes_written | bytes |
| Состояние кэша/границы | N/A | x-edge-result-type | CacheCacheStatus | fastly_info.state | cacheStatus |
| Метки ботов | labels | N/A | BotTags / ClientIPClass | N/A | N/A |
| Строка запроса | args | cs-uri-query | ClientRequestURI (includes query) | req.url (includes query) | queryStr |
| TTFB | N/A | time-taken | EdgeTimeToFirstByteMs | time.to_first_byte | turnAroundTimeMSec |
Анализ полученных данных: от кратких описаний проектов до информации о географических цитированиях
Исходные данные логов отвечают на пять вопросов, которые напрямую определяют производительность GEO. Ответы указывают, где нужно исправить ошибки. Аудит сайта показывает, что именно нужно исправить.
1. Какие боты с искусственным интеллектом заходят на ваш сайт?
Начните с анализа частоты посещений. Сайт, который никогда не посещали пользователи ChatGPT или Perplexity, невидим для ответов ИИ в реальном времени, независимо от того, насколько хорошо он ранжируется в традиционном поиске. Если эти боты отсутствуют в ваших логах, это первая проблема, которую необходимо диагностировать.
2. Какие страницы индексируются и как часто?
Страницы, которые ежедневно посещают поисковые роботы, – это страницы, которые они считают авторитетными по вашей теме. Высокая частота сканирования страницы, которую вы считаете второстепенной, говорит о том, что внешние источники направляют системы ИИ к этому контенту. Пропуск вашего лучшего контента – это прямая географическая нестыковка, а не ошибка округления.
3. Какие коды состояния они получают?
Проведите анализ: какой процент запросов с кодом 200, 3xx, 4xx и 5xx был возвращен каждым ИИ-ботом? Высокий процент ошибок 404 от ChatGPT-User указывает на географическую чрезвычайную ситуацию. Скопление ошибок 304 на недавно обновленных страницах означает, что системы ИИ могут ссылаться на вашу старую версию.
4. Перемещаются ли пользователи, использующие функцию автоматического получения информации, по нескольким страницам одновременно?
Один запрос ChatGPT-User означает, что запрос пользователя отобразился на вашей странице. Множественные запросы ChatGPT-User на разных страницах в течение короткого промежутка времени означают, что ИИ-агент работает на вашем сайте в рамках выполнения задачи: исследования, сравнения или составления. Группируйте запросы ChatGPT-User и Perplexity-User по временному интервалу сессии (запросы в течение 5 минут с одного IP-адреса) и ищите последовательности, охватывающие несколько страниц.
Это ваши наиболее ценные посещения, совершаемые агентами, и те, которые с наибольшей вероятностью приведут к конверсии или рекомендации. Если эти последовательности приводят к страницам с ошибками или неполным контентом, агент прекращает выполнение задачи. Это потеря географического охвата на уровне действий, а не только на уровне цитирования.
Почему JavaScript – это скрытый убийца GEO данных
Анализ более 500 миллионов запросов GPTBot, проведенный компаниями Vercel и MERJ, не выявил никаких признаков выполнения JavaScript-файлов. GPTBot запрашивает JavaScript-файлы примерно в 11,5% случаев, но не выполняет их.
Независимые подтверждения от Passionfruits и Oncrawl подтверждают, что эта закономерность наблюдается во всех основных системах сбора данных с использованием ИИ: GPTBot, ClaudeBot и PerplexityBot загружают файлы .js как текст, но не выполняют их. Google Gemini – единственная крупная система сбора данных с использованием ИИ, обладающая полной возможностью рендеринга JavaScript благодаря существующей инфраструктуре Googlebot.
Практический результат: любой контент, существующий только после выполнения JavaScript на стороне клиента, включая спецификации продуктов, таблицы цен, динамически отображаемые ответы на часто задаваемые вопросы и сравнительные данные, загружаемые через API, невидим для всех основных поисковых систем на основе ИИ, кроме Gemini.
Приложение React, использующее рендеринг на стороне клиента, может хорошо ранжироваться в поиске Google, оставаясь при этом совершенно незамеченным для ChatGPT и Claude. То же самое приложение, созданное с использованием рендеринга на стороне сервера или генерации статического сайта, не имеет этой проблемы: контент находится в исходном HTML-ответе, который именно и получают поисковые роботы с искусственным интеллектом.
В логах будет видно, что эти боты с высокой частотой сканируют ваши страницы, в то время как ваши географические ссылки остаются нулевыми. Аудит сайта выявляет ошибки рендеринга JavaScript на тех самых страницах, которые посещали боты с искусственным интеллектом, превращая эту невидимую проблему в приоритетный список исправлений.
Завершение цикла с помощью аудита сайта ЛогАналайзер
Анализ логов показывает, какие URL-адреса посещают боты с искусственным интеллектом и какие коды состояния они получают. Однако сам по себе он не может сказать, почему страница пропускается, почему возникают ошибки или почему не создаются ссылки, несмотря на индексацию.
Аудит сайта с использованием ЛогАналайзер замыкает этот цикл. Он работает на стороне сервера, охватывает более 100 технических факторов SEO и принимает данные из файлов логов напрямую через свой источник URL-адреса сводки логов.
Процесс интеграции:
- Экспортируйте ваши серверны лог-файлы (обычно это файл с названием access_log).
- В личном кабинете ЛогАналайзер создайте новый проект для вашего сайта.
- В разделе «Загрузки» импортируйте лог-файл.
- Ожидайте аудит. ЛогАналайзер проверяет каждый URL из вашего экспортированного журнала на соответствие контрольному списку из более чем 100 факторов.
- Ознакомьтесь с аналитикой и отчетами по вашему сайту: браузеры, LLM, краулеры, поисковые боты, пути и многое другое.
Пример:
- Анализ логов показал: «ClaudeBot посетил /solutions/crm-integration/ 47 раз» за один день.
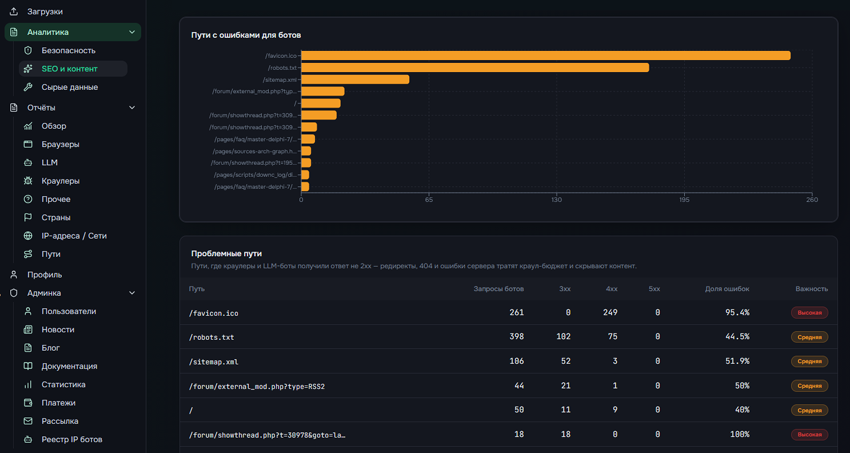
Коды состояния и пробелы в индексации: что означает каждый ответ бота для коэффициента цитирования вашего ИИ
Каждый ответ от ИИ-бота, отличный от 200, указывает на потенциальную потерю геолокационного сигнала. В таблице ниже приведено соответствие каждого кода состояния его геолокационной значимости и приоритету устранения проблемы.
| Код состояния | Что это сообщает боту | Геоинформационные последствия | Расстановка приоритетов |
|---|---|---|---|
200 | Успешное извлечение | Чистая загрузка. Мониторинг актуальности контента. | Поддерживать. |
301/302 | Перенаправление | Бот следует по цепочке из одного перехода. Цепочки, содержащие более двух переходов, рискуют потерять контент. | Средний уровень: консолидация цепочек редиректов. |
304 | Не изменено (кэшировано) | Бот использует свою кэшированную версию, которая может быть устаревшей. | Средний уровень сложности: очистка кэша CDN после крупных обновлений. |
403 | Запрещено | Бот заблокирован правилом WAF, блокировкой IP-адреса или файлом robots.txt. | Высокий уровень: проверьте, является ли блокировка преднамеренной. |
404 | Не найдено | Бот вернулся с пустыми руками. Прямой навигационный промах. | Критически важно: перенаправить, восстановить или удалить из внутренних ссылок. |
429 | Слишком много запросов | Бот ограничен по количеству запросов и может прервать сессию сканирования. | Высокий уровень: пороговые значения ограничения скорости проверки для известных диапазонов IP-адресов ботов. |
5xx | Ошибка сервера | Бот получил сообщение об ошибке. | Критически важно: немедленно устранить основную проблему на сервере. |
Каждая ошибка 4xx и 5xx, возникающая у бота с искусственным интеллектом, приводит к нерациональному использованию серверных ресурсов без доставки контента. Исправление этих ошибок одновременно улучшает производительность геолокации и эффективность сканирования Googlebot. Страницы, к которым боты с искусственным интеллектом не могут получить доступ, обычно являются теми страницами, с которыми Googlebot также испытывает трудности.
Анализ пробелов в обходе: два важных списка
Список 1: страницы, которые посещают боты с искусственным интеллектом и которых нет в вашей карте сайта
Как правило, на страницах-сиротах отсутствуют внутренние ссылки, используются старые URL-адреса из цепочек редиректов или контент, найденный через внешние обратные ссылки. Их сканируют боты с искусственным интеллектом, что может означать, что они ссылаются на устаревший или не соответствующий теме контент.
Решение: перенаправить на каноническую версию или вернуть ошибку 410, если контент не имеет смысла.
Список 2: страницы в вашей карте сайта Sitemap.xml, которые никогда не посещают ИИ-боты
Целевые географические объекты, которые пропускаются поисковыми роботами с искусственным интеллектом.
Распространенные причины:
- Рендеринг с помощью JavaScript делает контент невидимым для поискового робота.
- Правила Robots.txt перехватывают путь URL-адреса.
- Правила WAF блокируют известные диапазоны IP-адресов ботов.
- Медленное значение TTFB приводит к таймауту.
- Низкий уровень воспринимаемого авторитета по сравнению с конкурирующим контентом по той же теме.
Сигнал приоритезации контента, полученный на основе частоты сканирования
Страницы, которые ежедневно посещают пользователи, запустившие поиск по запросу, – это страницы, которые системы искусственного интеллекта считают авторитетными источниками информации по той или иной теме. Если ваши страницы с часто задаваемыми вопросами и контент с данными получают значительно более высокую частоту сканирования ИИ, чем страницы ваших продуктов, это обычно указывает на структурную проблему: вашим коммерческим страницам не хватает контента, отформатированного в формате «кратко изложенное», подкрепленного данными, который заставляет системы ИИ рассматривать страницы как надежные источники.
Решение проблемы заключается в структуре контента, а не в продвижении. Данные журналов дают вам сигнал. Используйте их.
Данные Similarweb о закономерностях цитирования ChatGPT подтверждают глубину этого сигнала. Согласно отчету Similarweb 2025 Gen-AI, треть всех цитирований ChatGPT приходится на URL-адреса с глубиной вложенности папок = 3, а значительная доля – с глубины вложенности 4 (четыре) и более.
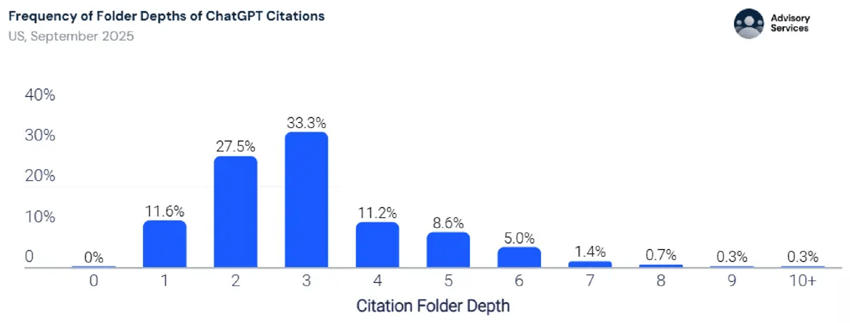
Аналогичная ситуация наблюдается и с информационными и исследовательскими запросами, где системы искусственного интеллекта ссылаются на конкретные статьи, руководства и страницы с данными, расположенные глубоко в архитектуре сайта.
После обновления ChatGPT в мае 2026 года, которое привело к росту реферального трафика на 157%, URL-адреса главной страницы и сайтов брендов получают значительно большую долю упоминаний наряду с подробным контентом, особенно для навигационных и транзакционных запросов.
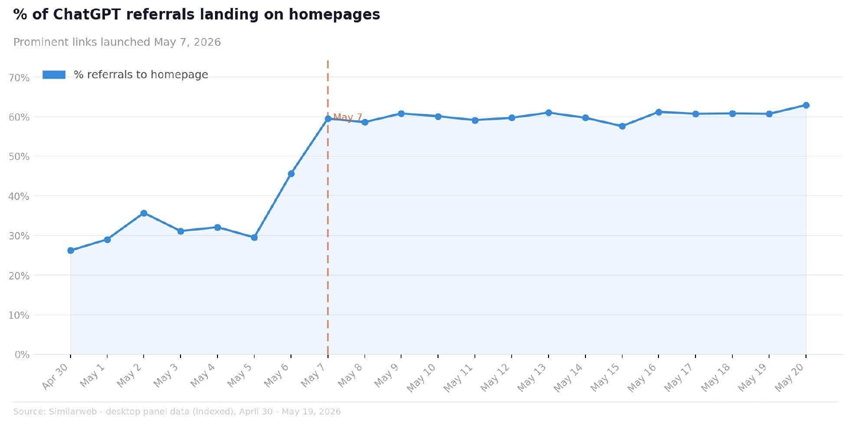
В ваших логах будут отображаться обе модели поведения: различные веб-краулеры, многократно обращающиеся к глубокому контенту, и пользовательские запросы, приводящие на страницы брендов и товаров. Отслеживание обеих моделей делает данные логов надежным индикатором потенциальной возможности цитирования во всем спектре поисковых запросов.
Рабочий процесс SIGNAL: от анализа логов до геолокационных действий
Анализ лог-файлов для GEO звучит как проект DevOps. Однако рабочий процесс SIGNAL превращает его в двухчасовую ежемесячную задачу, которую любой SEO-специалист может выполнить самостоятельно, без необходимости передачи его инженерам.
Аббревиатура SIGNAL расшифровывается как: Источник, Идентификация, Оценка, Сужение, Действие, Блокировка.
| Шаг | Действие | Инструмент | Время |
|---|---|---|---|
| Источник | Экспортируйте журналы работы ИИ-ботов из вашего WAF/CDN за последние 30 дней. | Пользовательский интерфейс Cloudflare / Консоль AWS / Fastly Edge Observer. | 15 мин |
| Идентифицировать | Сегментируйте URL-адреса, обращающиеся к ботам, по категориям: обучение, индексатор поиска, запросы, инициированные пользователем. Для запросов, инициированных пользователем, извлеките сессии агентов, сгруппировав client_ip + user_agent в 5-минутных окнах, чтобы составить полную карту взаимодействия агентов. | Электронные таблицы или Python. | 10 мин |
| Оценка | Загрузите URL-адреса, по которым обращались боты, в РокетКраулер в качестве источника сводной информации и запустите анализ. | Аудит сайта РокетКраулер. | 20 мин |
| Узкий | Отфильтруйте по коду состояния. Получите список ошибок 404, 403, 429 и 5xx. | Аудит сайта РокетКраулер. | 15 мин |
| Действовать | Определите исправления: редиректы, корректировка канонических ссылок, исправление рендеринга JavaScript, корректировка лимитов запросов. | Инженерный спринт или прямая работа с CMS. | Различный |
| Замок | Убедитесь, что исправления устранили проблемы с кодами состояния. Проверьте доступ к файлам llms.txt и /md/ в журналах. | Повторный запуск аудита сайта. | 20 мин |
Приведенная ниже диаграмма отображает полный цикл обработки сигнала, от экспорта необработанных логов до подтвержденного решения проблемы:
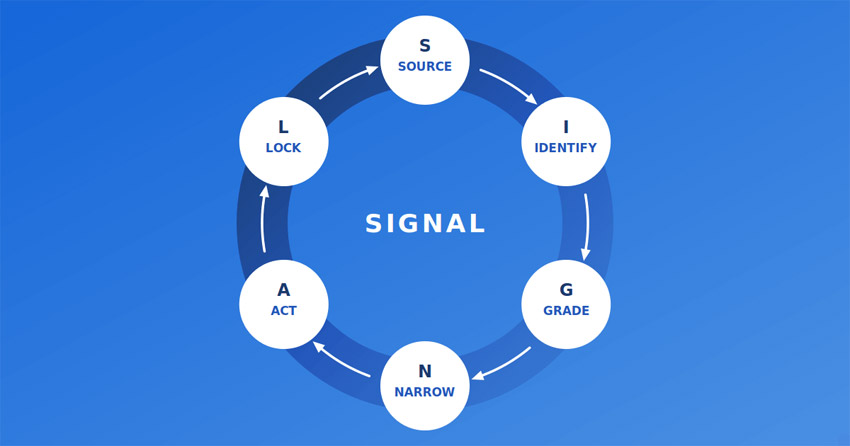
Для команд, не имеющих доступа к необработанным логам, ЛогАналайзер позволяет использовать API для автоматического сбора данных, и проверку каждого URL, посещенного ботами, по более чем 100 техническим факторам с одновременным отображением данных о трафике, обрабатываемом ИИ, в том же интерфейсе.
Боты уже есть в ваших логах. Вы анализируете файлы логов сервера, чтобы выяснить, что они увидели?
Журналы событий всегда были самым надежным и доступным методом технической SEO-диагностики. Изменилось лишь то, что те же данные, которые показывают, как Googlebot взаимодействует с вашим сайтом, теперь также показывают, как это делают десятки систем искусственного интеллекта: какие страницы они посещали, какие коды состояния получали и где останавливались.
Эти данные соответствуют первому этапу трехэтапной воронки. Анализ логов показывает, достигают ли агенты ИИ вашего контента (доступ). География показывает, цитируют ли они его (цитирование). Оптимизация поиска агентами показывает, что происходит, когда агент или пользователь переходит по этой ссылке на ваш сайт (действие). Вы не можете оптимизировать второй или третий этап, не зная, работает ли первый. Именно это и дает анализ серверных логов.
Часто задаваемые вопросы
Что такое анализ лог-файлов в SEO?
Анализ лог-файлов в SEO – это практика изучения журналов доступа к серверу, полной, невыборочной записи каждого HTTP-запроса к веб-сайту, чтобы понять, как боты и краулеры фактически взаимодействуют с вашим контентом. В отличие от Google Search Console, которая предоставляет выборочные данные Googlebot с задержкой в 2-3 дня, журналы сервера фиксируют весь трафик ботов в режиме реального времени, включая все краулеры с искусственным интеллектом, такие как ChatGPT, Claude и Perplexity. Это единственный источник данных, который напрямую показывает активность GPTBot, ClaudeBot и пользователей Perplexity.
Как найти трафик от ИИ-ботов в логах моего сервера?
Фильтруйте журналы по строке user-agent. Ключевые идентификаторы: GPTBot (обучение OpenAI), OAI-SearchBot (поиск OpenAI), ChatGPT-User (получение данных OpenAI в реальном времени), ClaudeBot (антропный), PerplexityBot (индекс Perplexity), Perplexity-User (Perplexity в реальном времени) и meta-externalagent (мета). Все пять основных платформ WAF и CDN предоставляют фильтры пользовательского интерфейса для этих строк в своих панелях управления безопасностью. Всегда проверяйте подлинность запросов с помощью обратного DNS-запроса на выборке IP-адресов, прежде чем использовать данные.
Что такое бюджет сканирования и как трафик от ботов с искусственным интеллектом влияет на него?
Бюджет сканирования – это концепция, определенная Google: количество URL-адресов, которые Googlebot может и хочет просканировать на сайте за определенный период, как это определено в документации Google Search Central. У ботов с искусственным интеллектом нет собственного бюджета сканирования. Они потребляют серверные мощности. Анализ корпоративных сайтов показывает, что потребление ресурсов ИИ-сканеров составляет до 40% от общей активности сканирования на сайтах с высокой посещаемостью. Поскольку боты с искусственным интеллектом и Googlebot конкурируют за одну и ту же серверную инфраструктуру, высокая посещаемость со стороны ботов с искусственным интеллектом может уменьшить доступные ресурсы для Googlebot, в результате чего он будет сканировать меньше страниц или снижать приоритет нового контента.
Выполняют ли боты с искусственным интеллектом JavaScript при сканировании моего сайта?
Нет, за одним исключением. Анализ более 500 миллионов запросов GPTBot не выявил никаких признаков выполнения JavaScript (Passionfruits, март 2026 г.). Анализ краулера Vercel и независимое исследование Oncrawl подтверждают эту закономерность: GPTBot, ClaudeBot и PerplexityBot загружают файлы JavaScript как текст, но не выполняют их. Только краулер Gemini от Google обладает полной возможностью рендеринга JavaScript благодаря инфраструктуре Googlebot. Любой контент, загружаемый только после выполнения JavaScript на стороне клиента, например, динамические характеристики продукта, ответы на часто задаваемые вопросы или таблицы цен, невидим для всех основных краулеров ИИ, кроме Gemini.
Что означает ошибка 404 от GPTBot или ClaudeBot для видимости моего географического местоположения?
Ошибка 404 означает, что бот вернул пустые данные. Для обучающих веб-краулеров, таких как GPTBot и ClaudeBot, страница отсутствует в их индексах. Для сервисов, получающих данные в реальном времени, таких как ChatGPT-User, ошибка 404 означает, что пользователь, задавший вопрос по вашей теме, не получил от вас никакого контента. Ваш бренд отсутствовал в этом конкретном ответе. Исправьте ошибки 404, связанные с ценными запросами, перенаправив на канонический эквивалент. Если страница удалена навсегда, используйте ошибку 410 и удалите URL-адрес из всех внутренних ссылок и карты сайта, чтобы боты перестали пытаться получить к ней доступ.
Как часто следует анализировать серверные журналы, и какие инструменты работают без доступа инженеров?
Ежемесячный анализ охватывает большинство сайтов. Выведите данные за 30 дней, загрузите их в ЛогАналайзер в качестве источника сводки логов, проанализируйте список ошибок и назначьте исправления. Настройте оповещение WAF о внезапных всплесках ответов 429 от известных диапазонов IP-адресов ботов с искусственным интеллектом; это сигнализирует о проблеме ограничения скорости запросов, требующей немедленного внимания. Для сайтов с частой публикацией выполняйте выборочную проверку в течение 48-72 часов после крупных публикаций.
В чем разница между логами CDN и логами исходного сервера при анализе с помощью ИИ-ботов?
Журналы CDN фиксируют каждый запрос на границе сети, включая заблокированный, ограниченный по скорости или обслуживаемый из кэша трафик, прежде чем он достигнет вашего исходного сервера. Журналы исходного сервера фиксируют только прошедшие запросы. Если конкретный ИИ-бот отсутствует в журналах вашего исходного сервера, это не означает, что он вас не сканирует: возможно, он заблокирован на границе CDN. Для анализа ИИ-ботов журналы CDN являются основным источником информации. Отсутствие в журналах исходного сервера не означает отсутствие в сети.
В чем разница между GPTBot и ChatGPT-User в логах сервера?
GPTBot – это асинхронный обучающий веб-краулер от OpenAI: он сканирует ваш сайт по расписанию, чтобы создавать и обновлять модель знаний, с интервалами повторного посещения примерно каждые 2-3 дня для часто обновляемых страниц. ChatGPT-User – это веб-краулер, работающий в режиме реального времени и запускающийся, когда запрос активного пользователя заставляет ChatGPT получить вашу страницу по требованию.
В ваших логах запрос ChatGPT-User является более сильным геосигналом: реальный пользователь активно интересовался вашей темой, и ваша страница отобразилась в ответ.
Можно ли подделать строки user-agent бота-ИИ в логах сервера?
Да. Любой может отправить запрос со строкой user-agent от GPTBot или ClaudeBot с любого сервера. Исследования, анализирующие трафик от ИИ-краулеров на нескольких площадках, показывают, что около 5-8% запросов, якобы поступающих от известных ИИ-краулеров, являются поддельными. Всегда проверяйте большой объем бот-трафика, сопоставляя IP-адрес запроса с опубликованными диапазонами IP-адресов оператора. Легитимный трафик GPTBot направляется в инфраструктуру Azure OpenAI; запросы из несовпадающих географических регионов или с неожиданными ASN, скорее всего, являются поддельными и должны рассматриваться как трафик от скрейперов, а не как активность ИИ-краулеров.
Достаточно ли файла robots.txt для контроля доступа со стороны ботов с искусственным интеллектом, или мне потребуется WAF (брандмауэр веб-приложений)?
Robots.txt – это добровольный протокол. Законные операторы, включая OpenAI, Anthropic и Google, его соблюдают, но он не предоставляет механизма принудительного исполнения. WAF блокирует запросы на границе сети до того, как они достигнут вашего исходного сервера, независимо от того, соблюдает ли бот robots.txt.
Однако для большинства целей SEO и GEO более важным является обратный вопрос: убедитесь, что robots.txt случайно не блокирует доступ к вашему контенту для ботов с искусственным интеллектом, которым вы хотите его предоставить. Регулярно проверяйте журналы WAF и robots.txt, чтобы убедиться в их согласованности и в том, что ваш список разрешенных ботов для получения контента, таких как ChatGPT-User и Perplexity-User, остается неизменным.
Как мне убедиться, что бот-трафик в моих логах действительно исходит от заявленного оператора ИИ?
Сравните запрошенный IP-адрес с опубликованными диапазонами IP-адресов оператора. OpenAI публикует свои диапазоны IP-адресов по адресу https://openai.com/gptbot-ranges.txt; Anthropic и другие крупные операторы публикуют аналогичную документацию.
Выполните обратный DNS-запрос для выборки IP-адресов: легитимный трафик GPTBot разрешается в инфраструктуру Azure OpenAI, а трафик ClaudeBot – в диапазоны AWS Anthropic. Запросы, которые выдают себя за известные боты ИИ, но разрешаются в неожиданные ASN или географические регионы, скорее всего, являются поддельными и должны рассматриваться как трафик от скрейперов.
Как часто боты с искусственным интеллектом повторно посещают страницы, и влияет ли это на мою стратегию обновления контента?
Частота повторных посещений значительно варьируется в зависимости от бота. Согласно 30-дневному исследованию логов на 12 сайтах смешанной тематики, опубликованному в апреле 2026 года, GPTBot повторно посещает страницы с высокой посещаемостью примерно каждые 2,4 дня, ClaudeBot – каждые 6,8 дня, а Google-Extended – каждые 14 дней. PerplexityBot и ChatGPT-User не следуют расписанию: они получают данные по запросу, когда запрос пользователя инициирует получение информации.
Это означает, что сигналы актуальности распространяются быстрее всего по экосистеме OpenAI и медленнее всего по конвейеру обучения ИИ Google. Если в ближайшей перспективе приоритетом является повышение точности цитирования ИИ, планируйте крупные обновления контента с учетом цикла повторного посещения GPTBot.
Гарантирует ли высокая частота индексации страницы искусственным интеллектом ее цитирование?
Нет. Сканирование и цитирование – это совершенно разные решения. Бот получает вашу страницу, чтобы оценить, достойна ли она цитирования, и он не цитирует все, что читает. Страницы, которые часто сканируются, но никогда не цитируются, обычно имеют одну из трех проблем: контент отображается на стороне клиента с помощью JavaScript, и бот получает пустой или поверхностный ответ; контент не структурирован таким образом, чтобы создавать извлекаемые, самодостаточные фрагменты, или страница освещает тему, по которой у бота уже есть более надежные источники. Высокая частота сканирования при нулевом количестве цитирований – это диагностика структуры контента, а не диагностика доступности.
Автор материала Лимор Баренхольц (Limor Barenholtz), оригинал статьи на сайте Similarweb.